Stellen Sie sich vor, Sie erstellen eine Funktion, die auf Daten zum Nutzerverhalten basiert, nur um später festzustellen, dass Ihnen fast die Hälfte der tatsächlichen Nutzungsmuster gefehlt hat.
Sie dachten, die Nutzer würden sich nicht mit einem bestimmten Flow beschäftigen, also haben Sie ihn entfernt — aber in Wirklichkeit nutzten 40% Ihrer Nutzer ihn aktiv. Du konntest sie einfach nicht sehen.
Dies ist kein hypothetisches Szenario. Laut den Untersuchungen von Google verbesserten Unternehmen, die serverseitiges Tracking implementieren, ihre Messeffektivität um 46%.
Das ist keine geringe Fehlerquote, das ist der Unterschied zwischen informierten Produktentscheidungen und Blindflug.
In diesem Artikel zeigen wir Ihnen, warum herkömmliches Tracking Produktteams versagt und wie serverseitiges Tracking das Spiel verändert.
Warum herkömmliches Tracking für Produktteams versagt
Über 900 Millionen Menschen weltweit verwenden Werbeblocker. Hinzu kommen immer strengere Datenschutzregeln für Browser — Apples Intelligent Tracking Prevention (ITP), das Blockieren von Cookies von Drittanbietern und die Datenschutzeinstellungen von Chrome. Das Ergebnis? Ihre Tracking-Pixel sind blockiert und Sie verlieren wichtige Produktdaten.
Für Produktteams geht es nicht nur um Marketing-Attribution. Es geht um:
- Verstehen, mit welchen Funktionen sich Benutzer tatsächlich beschäftigen
- Identifizierung von Schwachstellen in Benutzerabläufen
- Treffen datengestützter Priorisierungsentscheidungen
- Validierung von Produkthypothesen
Jede unsichtbare Benutzersitzung ist ein blinder Fleck in Ihrer Produktstrategie.
Clientseitiges vs. serverseitiges Tracking: Was ist der Unterschied?
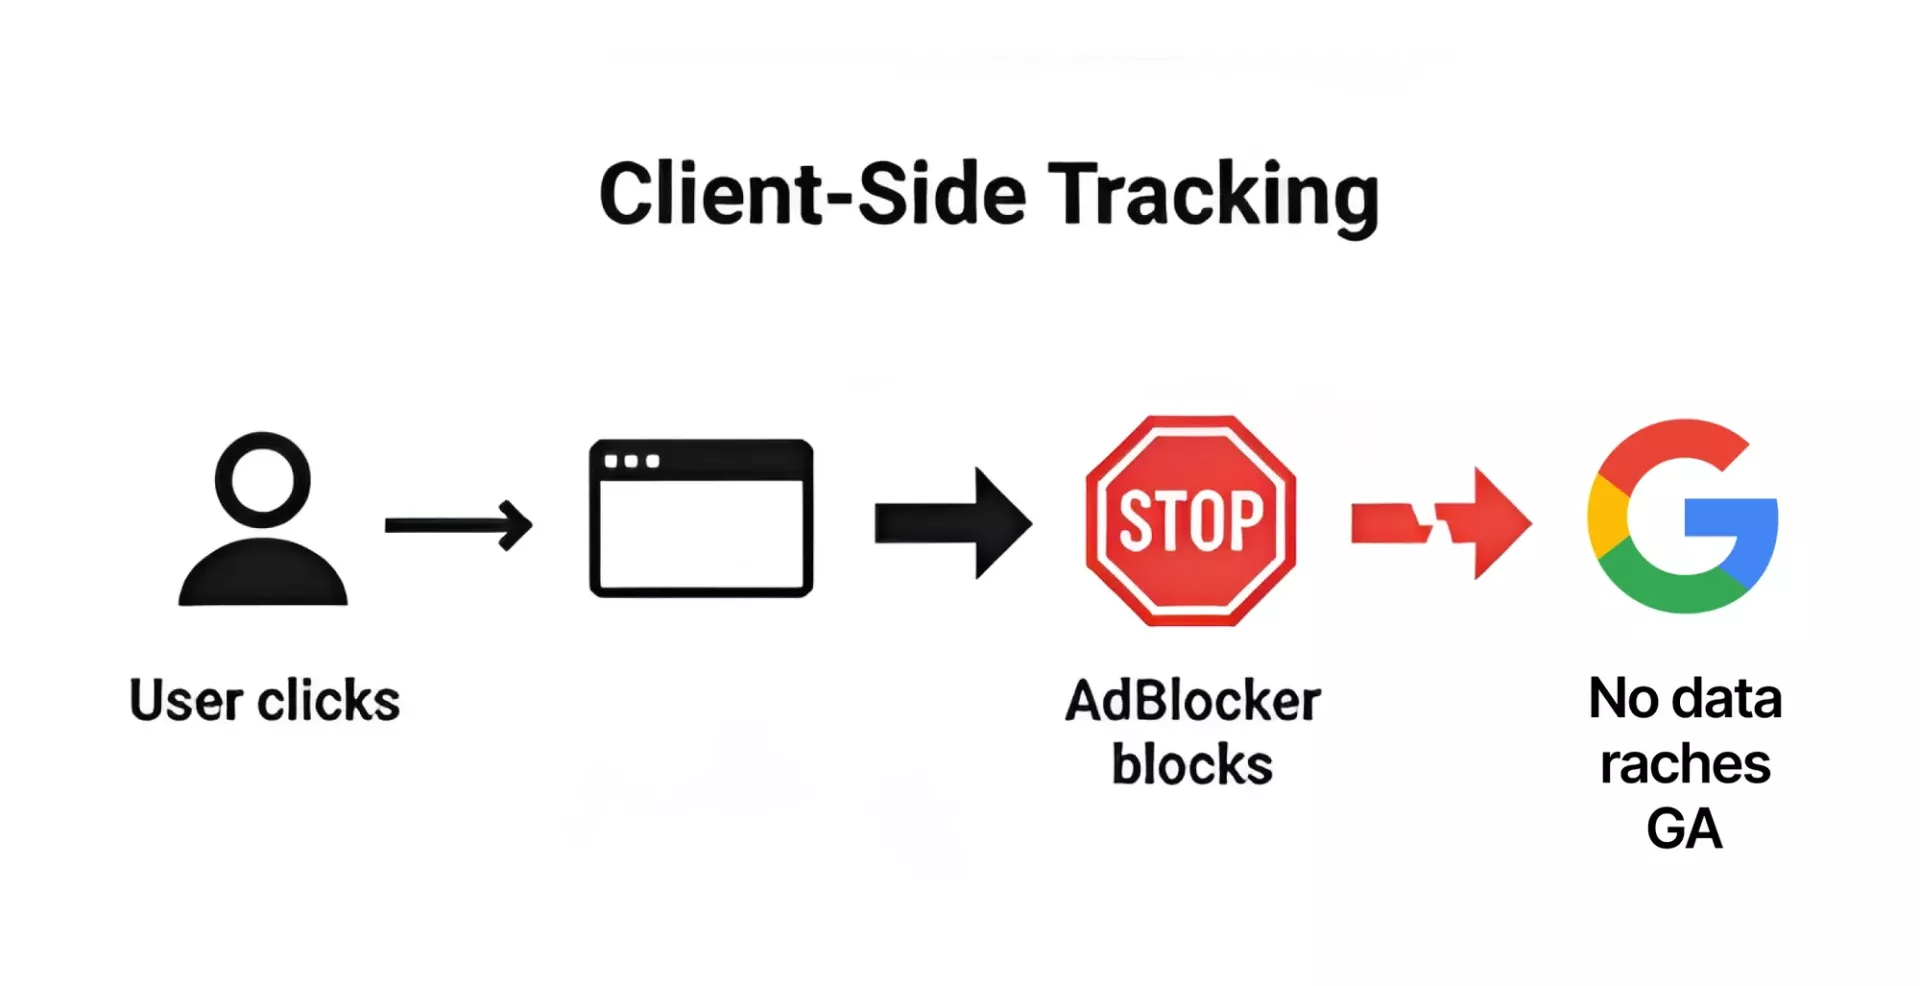
So funktioniert clientseitiges Tracking
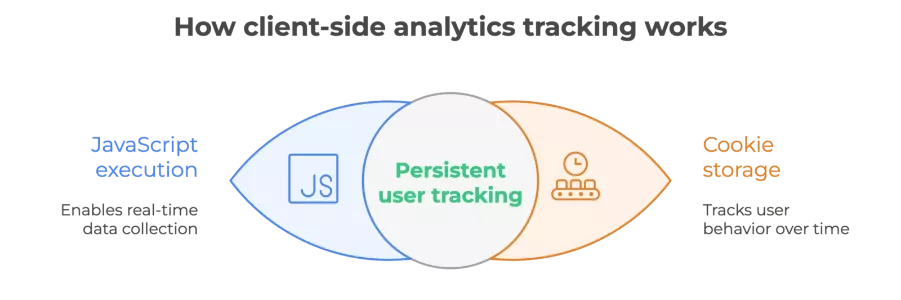
Im traditionellen Modell (clientseitig) passiert alles im Browser des Benutzers:
- Der Nutzer landet auf Ihrem Produkt
- Der Browser führt JavaScript-Code aus (z. B. Google Analytics, Mixpanel, Amplitude)
- Das Skript sammelt Daten und sendet sie direkt an Analysetools
- Cookies werden als „Drittanbieter“ (von externen Diensten) gespeichert
Das Problem? Jeder dieser Schritte kann blockiert werden durch:
- Werbeblocker
- Datenschutzeinstellungen des Browsers
- Einschränkungen für Drittanbieter-Cookies
- VPNs und Datenschutzerweiterungen sd
So funktioniert serverseitiges Tracking
Serverseitiges Tracking ändert die Regeln:
- Der Nutzer landet auf Ihrem Produkt
- Daten werden gesendet an dein Server (in deiner Domain)
- Der Server verarbeitet, filtert und reichert die Daten an
- Erst dann sendet der Server Daten an Analysetools
- Cookies werden als „Erstanbieter“ behandelt (von Ihrer Domain)
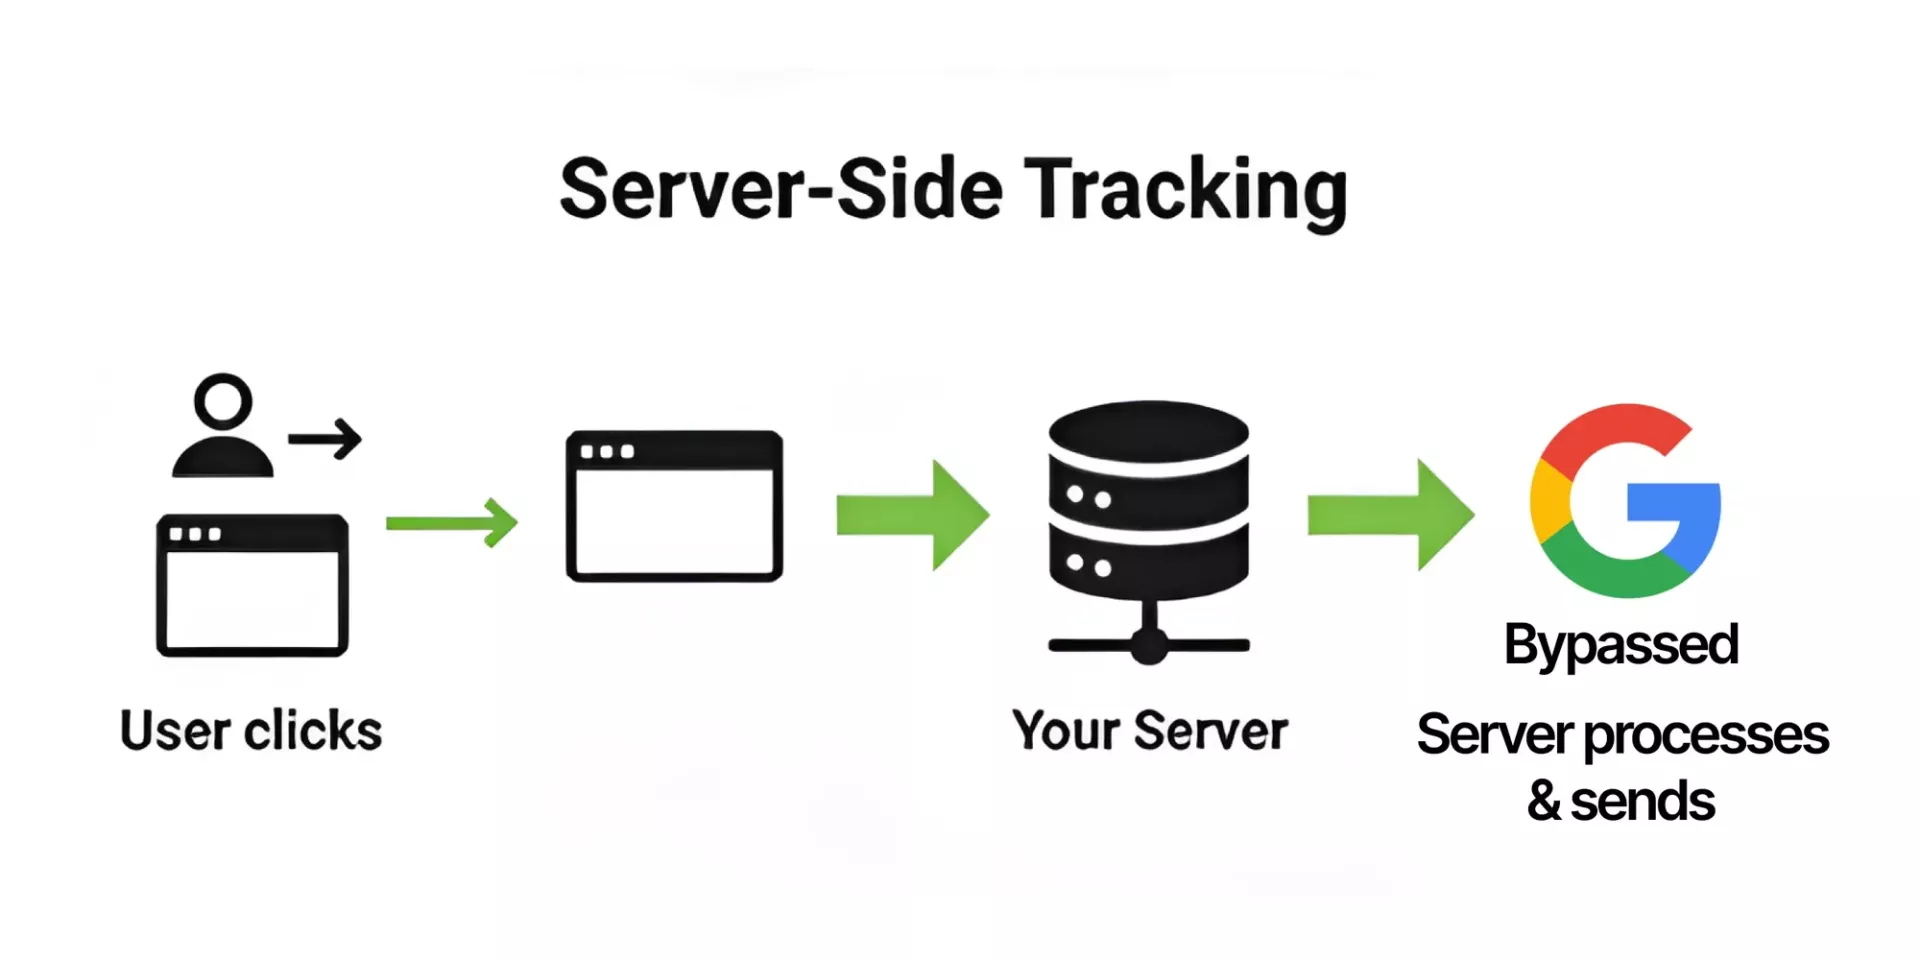
Der entscheidende Unterschied: Der Server arbeitet innerhalb Ihrer Domain, sodass Cookies als Erstanbieter behandelt werden. Werbeblocker und Browser blockieren sie nicht.
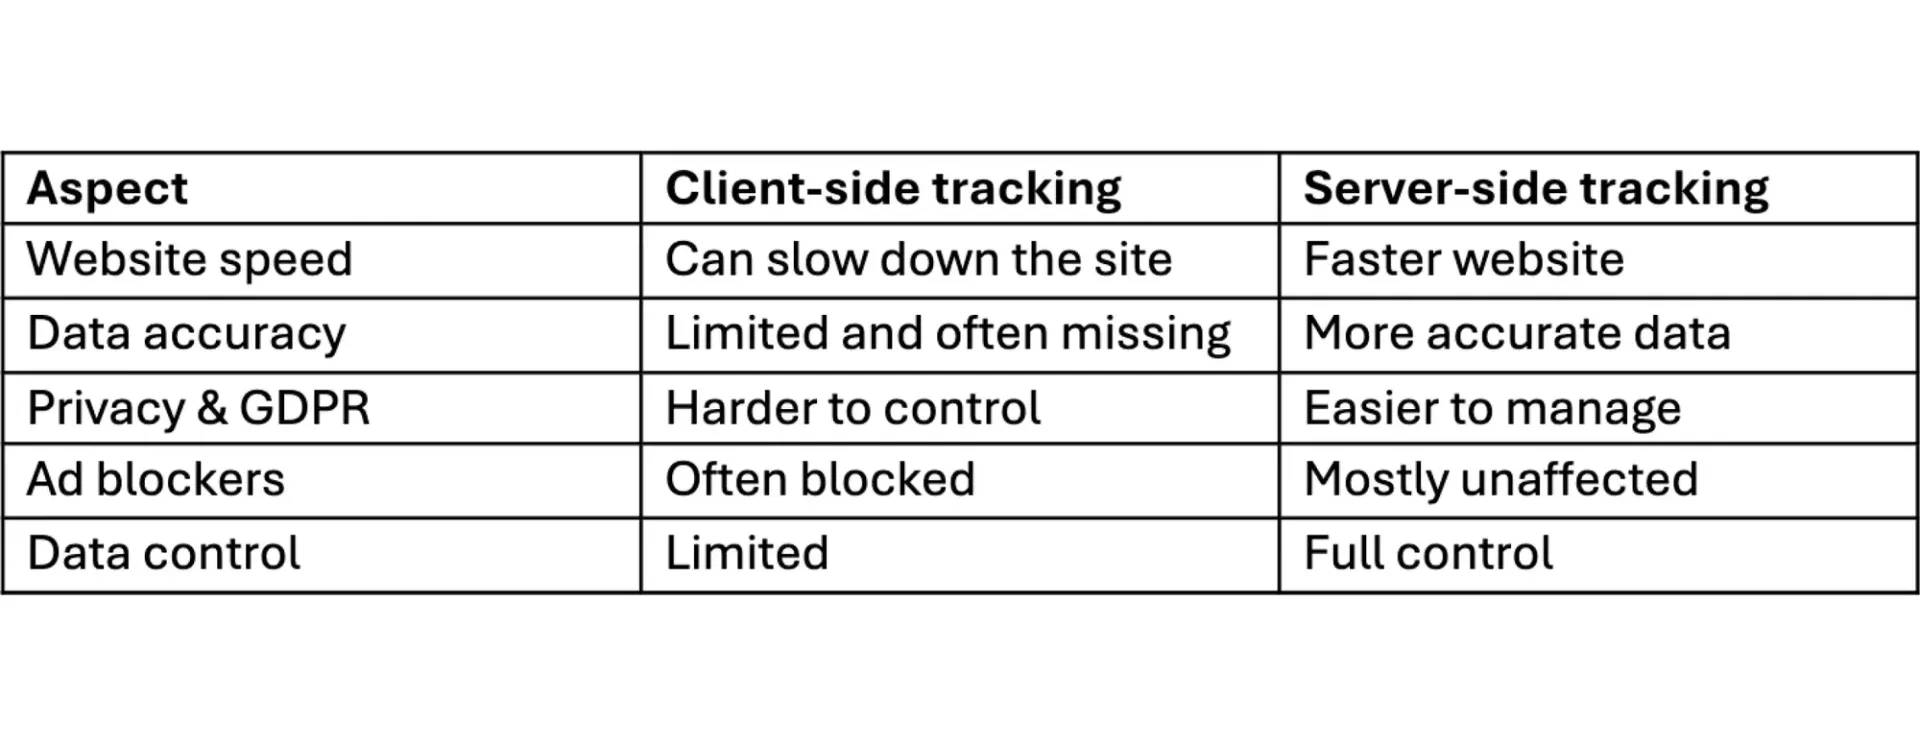
Clientseitig vs. serverseitig: Vergleich
Warum serverseitiges Tracking für die Produktentwicklung wichtig ist
1. Vollständige Daten zur Benutzerreise
Produktentscheidungen sollten auf vollständigen Daten basieren, nicht auf Fragmenten. Mit serverseitigem Tracking können Sie:
- Verfolgen Sie die gesamte Benutzerreise von der Registrierung bis zur Einführung wichtiger Funktionen
- Verstehen Sie die tatsächlichen Nutzungsmuster von Funktionen (nicht nur sichtbare)
- Identifizieren Sie, wo Benutzer in kritischen Abläufen abfallen
- Messen Sie echte Konversionsraten, nicht partielle
Beispiel: Sie erstellen ein SaaS-Produkt mit einem mehrstufigen Onboarding-Flow. Das clientseitige Tracking zeigt eine Abschlussrate von 60%. Aber 35% der Nutzer haben Werbeblocker — deine tatsächliche Abschlussrate könnte also bei 45% liegen. Das ist ein großer Unterschied in der Art und Weise, wie Sie die Onboarding-Optimierung angehen.
2. Bessere Priorisierung von Funktionen
Wenn Ihnen Daten von einem erheblichen Teil der Benutzer fehlen, bricht Ihr Priorisierungsrahmen zusammen. Sie könnten:
- Depriorisieren Sie Funktionen, die blockierte Benutzer wirklich lieben
- Investieren Sie zu viel in Funktionen, mit denen sich nur sichtbare Benutzer beschäftigen
- Treffen Sie falsche Annahmen über Benutzersegmente
Serverseitiges Tracking gibt Ihnen ein genaueres Bild davon, was für Ihre gesamte Nutzerbasis wichtig ist. Dies wird besonders wichtig, wenn Produktteams müssen schnelle, datengestützte Entscheidungen treffen darüber, was als nächstes gebaut werden soll.
3. Genaue Kohortenanalyse
Produktteams verlassen sich auf Kohortenanalysen, um die Kundenbindung, Aktivierung und Akzeptanz von Funktionen im Laufe der Zeit zu verstehen. Wenn Ihnen jedoch 30-40% der Nutzer in bestimmten Kohorten fehlen, ist Ihre Analyse grundlegend fehlerhaft.
Mit serverseitigem Tracking:
- Kohorten spiegeln das tatsächliche Nutzerverhalten in allen Segmenten wider
- Die Aufbewahrungsmetriken sind korrekt
- Sie können die Auswirkungen von Produktänderungen richtig messen
4. Echte A/B-Testergebnisse
Führen Sie einen A/B-Test durch, bei dem Variante A aufgrund von Werbeblockern 40% weniger getrackte Nutzer hat als Variante B? Ihre Testergebnisse sind bedeutungslos.
Serverseitiges Tracking gewährleistet:
- Beide Varianten haben eine vergleichbare Datenvollständigkeit
- Statistische Signifikanz ist real, kein Artefakt
- Sie können getrost gewinnbringende Varianten versenden
Die Vorteile von serverseitigem Tracking
1. Bessere Leistung = besseres Produkterlebnis
Jedes Skript, das im Browser ausgeführt wird, verlangsamt Ihr Produkt. Bei einem digitalen Produkt ist Leistung Teil der Benutzererfahrung. Beim serverseitigen Tracking wird diese Logik auf den Server übertragen, sodass:
- Seiten werden schneller geladen
- Benutzer warten nicht
- Das Produkt fühlt sich reaktionsschneller an
Studien zeigen, dass Jede Sekunde Verzögerung kostet Sie 7% an Konversionen. Für Produktteams bedeutet das, dass die Nutzer abspringen, bevor sie Ihre zentrale Wertstütze erleben.
2. Eigentum und Kontrolle der Daten
Der Server ist dein Gebiet. Sie haben die volle Kontrolle über:
- Welche Daten sammelst du
- Wie du es verarbeitest
- An wen schickst du es
- Wie lange lagerst du es
Sie können vertrauliche Informationen (z. B. PII, Zahlungsdetails) filtern, bevor sie externe Tools erreichen. Dabei geht es nicht nur um die Einhaltung der DSGVO, sondern auch um Produktverantwortung.
3. Daten von höherer Qualität
Der Server kann:
- Überprüfen Sie die Datenintegrität
- Daten mit zusätzlichem Kontext anreichern (z. B. Benutzerebene, Abonnementstatus)
- Filtern Sie Spam und ungültige Ereignisse
- Verbinden Sie Daten aus mehreren Quellen in einer einheitlichen Ansicht
Für Produktteams bedeutet dies sauberere Datensätze und zuverlässigere Erkenntnisse.
Die Nachteile des serverseitigen Trackings
1. Kosten
Serverseitiges Tracking erfordert:
- Hosting für den Server (Google Tag Manager serverseitig oder dedizierte Plattform)
- Technischer Aufbau
- Laufende Wartung
Der serverseitige Container (sGTM) von Google Tag Manager ist kostenlos, das Hosting auf der Google Cloud Platform jedoch nicht. Die Kosten beginnen bei mehreren zehn Dollar pro Monat.
2. Technische Komplexität
Das ist kein Plug-and-Play. Du brauchst:
- Verständnis der Tracking-Architektur
- Fähigkeiten zur Serverkonfiguration
- Kenntnis von Tags und Ereignissen
Ohne das richtige Team verbringen Sie möglicherweise mehr Zeit mit der Problembehandlung als mit dem Gewinnen von Erkenntnissen. An dieser Stelle wird die Frage der klassischen ähnlich kundenspezifisches Software-Dilemma - Manchmal bietet Ihnen die maßgeschneiderte Lösung mehr Wert, aber sie erfordert die richtigen Ressourcen und das richtige Engagement.
3. Wartungsaufwand
Jede Tracking-Änderung, jedes neue Event, jedes Update — alles muss auch serverseitig implementiert werden. Es ist eine zusätzliche Ebene, die Aufmerksamkeit erfordert.
So implementieren Sie serverseitiges Tracking
Option 1: Selbst gehostet (Google Tag Manager serverseitig)
Google stellt Google Tag Manager Server-Side (sGTM) bereit, den Sie auf der Google Cloud Platform bereitstellen können:
Vorteile:
- Kostenloser sGTM-Behälter
- Volle Kontrolle über die Konfiguration
- Integration mit dem Google-Ökosystem
Nachteile:
- Erfordert fortgeschrittenes technisches Wissen
- Sie müssen die Infrastruktur aktiv verwalten
- GCP-Hosting ist eine zusätzliche Gebühr
Option 2: Dedizierte Plattformen (z. B. Stape)
Plattformen wie Stape vereinfachen den Prozess:
Vorteile:
- Einfachere Einrichtung
- Hosting und Infrastrukturwartung werden von der Plattform übernommen
- Vorgefertigte Lösungen für beliebte Tools (Facebook Pixel, GA4, Google Ads)
Nachteile:
- Höhere Kosten (insbesondere bei mehreren Gateways)
- Weniger Flexibilität bei der Anpassung
- Abhängigkeit vom Anbieter
Option 3: Vorgefertigte Gateways für einzelne Tools
Für Teams, die nur Tracking für einen Kanal benötigen (z. B. Analysen), gibt es spezielle Lösungen:
API-Gateway für Metakomantierungen - ermöglicht serverseitiges Tracking für Facebook ohne vollständige sGTM-Setup. Ähnliche Lösungen gibt es für GA4, Google Ads, Snapchat, TikTok.
Vorteile:
- Schnellste Implementierung
- Sie müssen nicht die gesamte Infrastruktur verwalten
Nachteile:
- Beschränkt auf ein Tool
- Die Kosten steigen, wenn Sie mehr Kanäle benötigen
- Keine Anpassungsmöglichkeiten
Ist serverseitiges Tracking das Richtige für Ihr Produktteam?
Serverseitiges Tracking ist die Zukunft, aber nicht jeder braucht es gerade jetzt. Die Entscheidung hängt oft davon ab, Ihre tatsächlichen Bedürfnisse zu verstehen und nicht die Komplexität der Implementierung — ähnlich wie zu wissen, wann Transparenz in der IT wirklich wichtig ist.
Es lohnt sich auf jeden Fall, wenn:
- Sie haben erheblichen Benutzerverkehr (über 10.000 aktive Benutzer pro Monat)
- Produktentscheidungen hängen stark von Verhaltensanalysen ab
- Du verarbeitest sensible Daten und sorgst dich um die Einhaltung der DSGVO
- Sie benötigen eine genaue Kohorten- und Retentionsanalyse
- Sie führen häufig A/B-Tests durch
Du kannst warten, wenn:
- Sie befinden sich in einer frühen MVP-Phase mit begrenzten Benutzern
- Das clientseitige Tracking gibt Ihnen immer noch ein ausreichendes Signal
- Sie haben keine technischen Ressourcen für Implementierung und Wartung
- Ihr Produkt hat keine komplexen Nutzerströme, die es zu verfolgen gilt
Eine lustige Tatsache zum Abschluss
In den 1990er und frühen 2000er Jahren war alles „serverseitig“. Jeder Benutzerklick generierte eine Serveranfrage, die protokolliert wurde. Die Analytik funktionierte auf der Grundlage von Serverprotokollen.
Dann kam die Web 2.0-Ära, JavaScript begann zu dominieren, und wir wechselten zur Client-Seite. Jetzt, fast 30 Jahre später, kehren wir zu den Wurzeln zurück. In der Geschichte hat sich der Kreis geschlossen.
Aber dieses Mal ist serverseitiges Tracking nicht nur eine Rückkehr in die Vergangenheit — es ist eine Weiterentwicklung. Wir kombinieren die Geschwindigkeit und Interaktivität des modernen Webs mit der Kontrolle und dem Datenschutz des Servers. Es ist das Beste aus beiden Welten.
Zusammenfassung
Serverseitiges Tracking ist die Antwort auf die zunehmenden Probleme mit Cookie-Blockern, Werbeblockern und Datenschutzbestimmungen. Es gibt dir:
- Vollständigere Konversionsdaten (bis zu 46% bessere Ergebnisse)
- Schnellere Produktleistung
- Kontrolle über die Privatsphäre der Nutzer
- Fähigkeit, Daten zu filtern und anzureichern
Es erfordert aber auch finanzielle und zeitliche Investitionen. Es ist keine Plug-and-Play-Lösung, aber für Produktteams, die auf Daten angewiesen sind und intelligent skalieren möchten, ist es nicht die Zukunft, sondern die Gegenwart.
Möchten Sie über die neuesten Trends in der Technologie und Produktentwicklung auf dem Laufenden bleiben? Abonnieren Sie unseren Newsletter - Wir liefern jede Woche wertvolle Inhalte für Geschäftsinhaber und Produktmanager.
Sie suchen nach umfassender Unterstützung in den Bereichen Analytik und Produktstrategie? Auschecken Fleißig - unsere Marke, die sich auf Marketingstrategien und die Implementierung fortschrittlicher Tracking-Lösungen für wachsende Unternehmen spezialisiert hat.